1. Introducere
Laboratorul trecut s-a studiat problema clasificarii unei baze de date simple (MNIST) cu ajutorul unei retele de tip perceptron multistrat (Multilayer Perceptron - MLP). Pe parcursul acestui studiu de caz s-au abordat pasii elementari pentru rezolvarea unei astfel de probleme (alegerea arhitecturii, a functiei loss, a optimizatorului, a ratei de invatare, impartirea bazei de date in batch-uri precum si bucla de invatare.
In continuare, solutia usoara din laboratorul trecut va fi extinsa prin folosirea arhitecturilor mult mai puternice de tip retele convolutionale (CNN). De asemenea se vor discuta si alte aspecte utile in utilizarea retelelor neuronale.
2. Motivatie si aspecte generale
Reteaua neuronala folosita anterior a utilizat drept trasaturi de intrare chiar pixelii constituenti ai imaginilor. Desi rezultatele au fost satisfacatoare, acest deznodamant nu ar fi fost la fel de probabil pentru baze de date mai complicate. In general, valorile directe ale pixelilor nu sunt considerate a fi trasaturi puternice. Cu acest scop se utilizeaza extractoare de trasaturi, precum HoG si LBP, care surprind mai bine informatia spatiala din fiecare zona de interes sau din jurul fiecarui pixel.
Retelele convolutionale au adus o serie de imbunatatiri in ceea ce proveste algoritmii de machine learning. O parte dintre acestea vor fi discutate ulteiror. Drept punct de plecare se va face referire la schema generala a unei retele convolutionale:

Se pot observa doua zone principale:
- Prima, formata din straturile de tip Convolution si Pooling
- A doua, formata din straturi Fully Connected
Prima zona s-a dovedit a avea rolul de extractor de trasaturi. Primele straturi convolutionale extrag informatii de tip contururi, iar acestea devin mai complexe odata cu parcurgerea retelei. S-a observat ca trasaturile iesite dupa prima zona a retelei sunt puternice (desi nu s-a descoperit ce inseamna), in general fiind mai reprezentative decat trasaturile obtinute prin aplicarea algoritmilor HoG sau LBP.
A doua zona, cu straturile Fully Connected este practic o retea MLP aplicata trasaturilor extrase de zona convolutionala a retelei.
2.1. Straturile convolutionale
Acest tip de strat este unitatea de baza din noile arhitecturi. Facand o analogie cu procedeele consacrate din prelucrarea imaginilor, un strat convolutional realizeaza o serie de operatii de filtrare liniara pe matricea de la intrarea in strat (pe rand). Aceasta matrice poate fi imaginea in sine, sau rezultatul altui strat, denumit feature map (harta de trasaturi). Un fapt relevant in acest caz este ca nucleul de convolutie are adancimea matricei de la intrare (ex. 3 pentru o imagine RGB). De la modul in sine in care functioneaza stratul convolutional se pot observa niste diferente fata de modul de functionare al MLP, precum si proprietati relevante:
- sparse interactions (interactiuni "rare"): spre deosebire de MLP, undeva fiecare neuron din stratul $N$ interactiuna cu toti neuronii din stratul $N+1$, la un CNN doar o serie de neuroni din stratul curent vor participa la neuronul din stratul urmator (zona denumita campul receptiv, receptive field). Acest fapt implica stocarea a mai putini parametri, si a operatii mai putine;
- partajarea parametrilor: nucleul de convolutie este folosit pentru intreaga imagine, deci ponderile care conduc la un anume neuron din stratul urmator sunt mereu aceleasi. Aceasta trasatura este pusa in contrast cu arhitectura MLP, unde fiecare pondere era folosita o singura data, pentru o pereche anume de neuroni;
- echivarianta la translatie a reprezentarilor: se refera la proprietatea ca daca imaginea de intrare sufera o transformare de tip translatie, si harta de trasaturi de iesire va suferi aceeasi modificare.
Toate straturile convolutionale sunt urmate de o functie de activare (in general Rectified Linear Unit - ReLU). Pentru a creea un strat convolutional in tensorflow se foloseste sintaxa:
conv_x = tf.layers.conv2d(inputs = input, filters = numar_filtre, kernel_size = [linii_filtru, coloane_filtru], strides = (pas_orizontal,pas_vertical), padding = 'same', activation = tf.nn.relu, name = 'nume')
Forma corecta pentru input este de tipul [nr_imag,linii,coloane,canale]
Argumentul strides se refera la pasul pe care il face nucleul convolutional dupa ce opereaza asupra zonei curente. Un pas de (1,1) inseamna ca va parcurge toti neuronii.
Argumentul padding se leaga de capetele imaginii. Se decide daca imaginea va fi bordata cu valori de 0, astfel incat sa fie parcursi toti pixelii din imagine ('same') sau se vor ignora neuronii din capatele imaginii ('valid'). Daca padding-ul este 'same' si pasul este (1,1), atunci hartile de trasaturi vor avea acelasi numar de linii si coloane ca stratul din care provin.
2.2. Straturile de pooling
Operatia de pooling este cel mai bine tradusa in limba romana ca o "grupare", o subesantionare. Pe scurt, aceasta operatie inlocuieste valoarea unei zone din imagine/harta de trasaturi cu o statistica a acelei zone. Functia de max-pooling este cea mai folosita in aplicatii si inlocuieste valoarea dintr-o zona bine definita cu maximul acelei zone, rezultand intr-o harta de trasaturi mai mica, dar care pastreaza cea mai relevanta statistica. In acest mod, pe langa reducerea dimensionalitatii, se obtine si o invarianta la translatii mici.
Modul de creare a unui strat de max-pooling in tensorflow care sa ia vecinatati 2x2:
pool_x = tf.layers.max_pooling2d(inputs = input, pool_size = [2,2], strides = (2,2))
2.3 Straturile fully connected
Dupa cum a fost mentionat anterior, aceste straturi sunt cele dens conectate, obisnuite dintr-un MLP. Inainte de a le putea folosi, hartile de trasaturi trebuie aplatizate (vectorizate):
flat = tf.layers.flatten(harti_trasaturi)
Pentru a crea un strat dens:
fc = tf.layers.dense(inputs = input, units = nr_neuroni_stratul_urmator, activation = tf.nn.relu, name='nume')
Activarea ar trebui sa fie None pentru ultimul strat.
3. Arhitecturi de baza
Exista o multitudine de arhitecturi actuale, unele care au adus imbunatatiri marginale, altele care sunt specializate pe o anumita sarcina, dar cateva arhitecturi sunt considerate a fi pietre de temelie pentru domeniu. In continuare vor fi prezentate cateva arhitecturi care au atras o atentie foarte mare la momentul aparitiei lor.
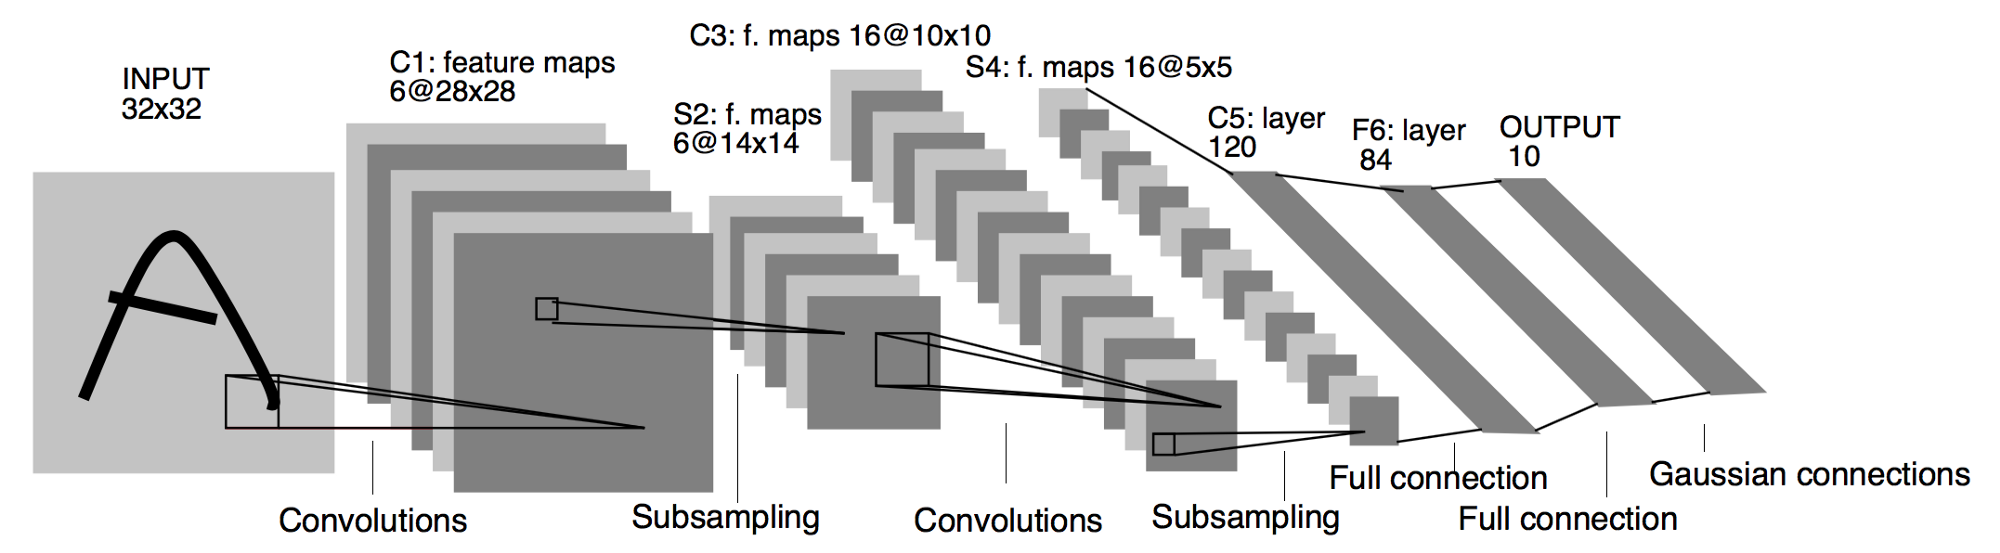
3.1. LeNet-5
Cea mai veche arhitectura convolutionala a fost prezentata in 1998 cu scopul de a recunoaste cifre scrise de mana in documente. A fost conceputa pentru imagini de rezolutie mica (32 x 32 pixeli) si, din cauza constrangerilor vremii in ceea ce priveste puterea de calcul, nu a prezentat o adancime mare (doar 2 straturi convolutionale cu nuclee de 5 x 5 pixeli). Schema arhitecturii:
3.2. AlexNet
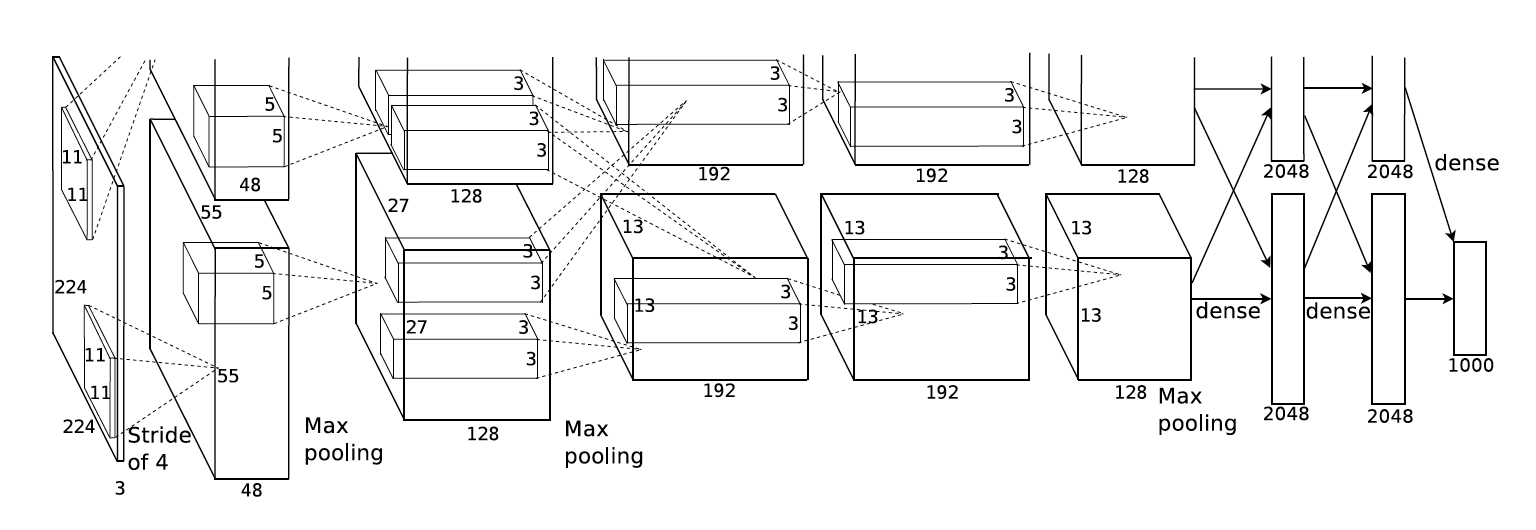
Dupa mai bine de un deceniu (in 2012), arhitectura AlexNet a fost prima arhitectura neuronala care a castigat concursul ILSVRC cu o arhitectura avand 5 straturi convolutionale, imagini de intrare considerabil mai mari, nuclee de convolutie mai mari in straturile initiale (11 x 11) cu pasi mai mari de parcurgere a imaginii si a folosit activari de tip ReLU. Aceasta arhitectura mult mai puternica decat ce s-a vehiculat pana in acel moment a fost antrenata cu ajutorul a doua GPU-uri performante. Schema arhitecturii:
3.3 VGG
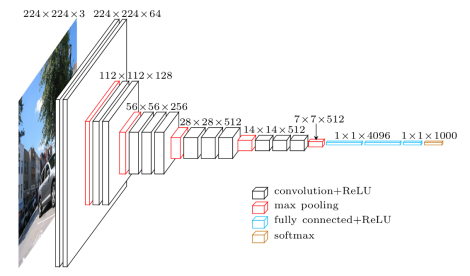
Urmatorul pas important adus in domeniu a fost studiul impactului adancimii unei retele. In acest scop, retelele din familia VGG au demonstrat cresterea performantei odata cu adancimea. Reteaua VGG-19 (de la cele 19 straturi neuronale de orice tip) este printre cele mai mari retele utilizate in termeni de numar de parametri care trebuie invatati si cei tinuti minte in etapa de inferenta (propagare inainte a informatiei). In prezent, aceasta arhitectura este adesea folosita pentru trasaturile generale puternice extrase dupa ultimul strat convolutional, utile si in alte sarcini decat clasificarea. O alta observatie importanta este reprezentata de reducerea tuturor nucleelor de convolutie la dimensiunea 3 x 3 cu pas 1 la deplasare. Schema arhitecturii VGG-16:
3.4. ResNet
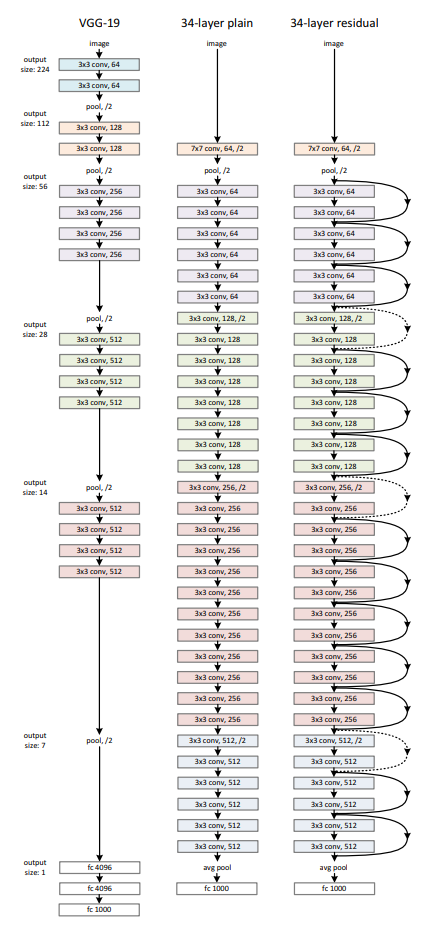
Aparuta mai recent ca celelalte arhitecturi prezentate, importanta acestei arhitecturi a fost uriasa, rezolvand problema vanishing gradient. Aceasta reprezenta scaderea puternica a gradientilor odata cu avansarea in retea in etapa de propagare inapoi. Practic, retelele cu un numar mare de straturi erau foarte greu de antrenat. Solutia acestui tip de arhitectura a fost introducerea blocului "rezidual", care presupunea ca la iesirea dintr-un bloc compus din mai multe convolutii se adauga si intrarea in bloc. Aceste conectiuni de tip "scurtatura" (sau "scurtcircuit") au permis crearea unor retele mult mai adanci (inclusiv 1000 de straturi). Ca o consecinta a numarului crescut de straturi, s-a putut scadea numarul de filtre per strat, pastrand numarul de parametri care trebuiau invatati relativ redus. Arhitectura ResNet-34 este ilustrata alaturi de VGG-19 (care are un numar considerabil mai mare de parametri):
Exercitiu. Incarcati baza de date MNIST si antrenati o retea convolutionala care are urmatoarea forma: convolutie + pooling + convolutie + pooling + 2 fully connected. Functiile modificate pentru citirea bazei de date se afla mai jos.
Atentie! Nu uitati de forma ceruta de straturile de convolutie, deci trebuie modificata si intrarea in retea.
import numpy as np
# Nu trebuie tf pentru citirea datelor, dar trebuie pentru tot restul
import tensorflow as tf
def get_MNIST_train():

    mnist_train_data = np.zeros([60000,784])
    mnist_train_labels = np.zeros(60000)

    f = open('train-images.idx3-ubyte','r',encoding = 'latin-1')
    g = open('train-labels.idx1-ubyte','r',encoding = 'latin-1')

    byte = f.read(16) #4 bytes magic number, 4 bytes nr imag, 4 bytes nr linii, 4 bytes nr coloane
    byte_label = g.read(8) #4bytes magic number, 4 bytes nr labels

    mnist_train_data = np.fromfile(f,dtype=np.uint8).reshape(60000,784)
    mnist_train_data = mnist_train_data.reshape(60000,28,28,1)
    mnist_train_labels = np.fromfile(g,dtype=np.uint8)

    return mnist_train_data, mnist_train_labels

def get_MNIST_test():

    mnist_test_data = np.zeros([10000,784])
    mnist_test_labels = np.zeros(10000)

    f = open('t10k-images.idx3-ubyte','r',encoding = 'latin-1')
    g = open('t10k-labels.idx1-ubyte','r',encoding = 'latin-1')

    byte = f.read(16) #4 bytes magic number, 4 bytes nr imag, 4 bytes nr linii, 4 bytes nr coloane
    byte_label = g.read(8) #4bytes magic number, 4 bytes nr labels

    mnist_test_data = np.fromfile(f,dtype=np.uint8).reshape(10000,784)
    mnist_test_data = mnist_test_data.reshape(10000,28,28,1)
    mnist_test_labels = np.fromfile(g,dtype=np.uint8)

    return mnist_test_data, mnist_test_labels
4.Utilizarea bazelor de date cu pipeline-ul Tensorflow
Laboratorul trecut a fost mentionata o metoda de lucru cu bazele de date mari cu imagini, care presupunea crearea unui fisier care sa contina caile catre imagini, precum si etichetele. Tensorflow ofera mai multe solutii pentru gestionarea unor situatii de acest tip. In continuare vor fi prezentati pasii necesari pentru crearea si folosirea unei baze de date cu ajutorul Tensorflow:
- Se creeaza matricile/vectorii care contin numele fisierelor, respectiv etichetele si se defineste dimensiunea unui batch
- Se creeaza un obiect de tip Dataset din aceste matrici. Biblioteca le va considera tot tensori, astfel ca:
dataset = tf.data.Dataset.from_tensor_slices((vector_nume,vector_etichete)) - Se scrie o functie de prelucrare a datelor, precum:
def parse_function(data_file,label): name = tf.read_file(data_file) img = tf.image.decode_jpeg(name,channels=3) # Exista functii si pentru alte formate, precum si pentru citirea oricarui tip de imagine # Normalizari (care pot cere si eventuale conversii in tipul float # Ex. img = tf.image.per_image_standardization(img), care face imaginea de medie 0 si varianta 1 return img, label - Aceasta functie este asociata obiectului nostru de tip Dataset:
dataset = dataset.map(parse_function,num_threads=8,output_buffer_size = 100*batch_size - Se mentioneaza faptul ca datele trebuie alese aleator, nu secvential, pentru citire:
dataset = dataset.shuffle(buffer_size=4096) - Metoda de creare a batch-urilor:
dataset = dataset.batch(batch_size) - In continuare, ne trebuie un iterator care poate sa parcurga baza de date, se defineste metoda de obtinere a unui nou batch de la iterator, precum si o metoda care sa il initializeze:
iterator = tf.data.Iterator.from_structure(dataset.output_types,dataset.output_shapes
next_batch = iterator.get_next()
iterator_init = iterator.make_initializer(dataset)
Aceasta portiune poate fi (si este recomandat sa fie) integrata intr-o clasa definita de utilizator, pentru gestiunea mai usoara a codului, dar nu este crucial. De asemenea, se poate specifica ca toate aceste operatiuni sa fie realizate de catre CPU, pentru a nu consuma resursele GPU (cu ajutorul with tf.device('/cpu:0'):)
Tot ce ramane de facut este ca la fiecare inceput de epoca sa se intializeze iteratorul:
sess.run(iterator_init)si la fiecare iteratie a epocii sa obtin batch-ul:
img_batch,labels_batch = sess.run(next_batch)
4.1. Transformari ale imaginilor
In functia de prelucrare a imaginilor de intrare se pot aplica, inainte de iesire, o serie de transformari care ar putea ajuta la performanta finala a clasificatorului, precum:
 tf.image.random_contrast
 tf.image.per_image_standardization
 tf.image.flip_left_right
5. Tensorboard
Tensorboard este un utilitar pus la dispozitie pentru vizualizarea diverselor informatii din timpul antrenarii, precum si informatii despre retea. Desi familiarizarea cu Tensorboard nu este scopul acestui laborator, monitorizarea progresului ajuta la alegerea corecta a modificarilor care sa creasca performanta. Pentru a vizualiza evolutia unui scalar, acesta trebuie scris in sumarul retelei:
tf.summary.scalar('Nume',tensor)Spre exemplu, tensorul ales poate fi valoarea loss-ului. Dupa definirea tensorilor care se doresc a fi urmariti, trebuie ca sumarele partiale sa fie reunite si sa se defineasca locul in care vor fi scrise informatiile
merged_summary = tf.summary.merge_all()
writer = tf.summary.FileWriter(cale)
Pentru a vedea graful retelei, dupa intrarea in sesiune:
writer.add_graph(sess.graph)iar pentru a actualiza valorile afisate trebuie rulata periodic (dupa fiecare epoca sau iteratie, la alegere):
s = sess.run(merged_summary,feed_dict={...}
writer.add_summary(s,nr_epoca_sau_nr_iteratie)
Pentru a vedea situatia actuala se ruleaza (din anaconda):
tensorboard --logdir=caleDaca se doreste vizualizarea a mai multe instante de tensorboard, pe langa --logdir se poate specifica si --port pentru alegerea portului pe care sa ruleze serverul tensorboard. Dupa aceea, din browser se acceseaza adresa si portul indicate in terminal.
Atentie! Nu se poate vizualiza o variabila fara ca aceasta sa fie tensor. Spre exemplu, daca s-ar vrea vederea progresului acuratetetii, folosind o functie scrisa de utilizator (cum este in cazul curent), aceasta valoare trebuie pasata neaparat unui tensor (cum ar fi o constanta). O solutie simpla este: Inainte de bucla de invatare
acuratete = tf.Variable(0.0)
tf.summary.scalar('Acuratete',acuratete)
In bucla de invatare, in loc de s = sess.run(merged_summary) se ruleaza
sess.run(acuratete.assign(acc))
s = sess.run(merged_summary)
writer.add_summary(s,epoca)
Atentie! Rularea succesiva a aceluiasi algoritm, fara stergerea continutului directorului in care se afla log-ul tensorboard, va conduce la valori suprascrise.
6. Rularea retelei dupa antrenare si testare
In practica se doreste rularea retelei si pe cazuri noi (pe langa cele de la antrenare si de la testare). Pentru aceasta, trebuie tinut minte ca:
- Conteaza cu ce functie este citita imaginea. Daca imaginea este citita folosind OpenCV, formatul ei standard este BGR si va trebui convertita (in RGB, grayscale, etc.). Din acest motiv poate este mai simpla citirea cu scikit-image
- Odata citita imaginea, ea trebuie sa sufere aceleasi normari ca imaginile care au intrat in retea la antrenare si testare (functia de prelucrare de imagine folosita de clasa Dataset nu mai este disponibila)
- Reteaua va cere intotdeauna acelasi format de date
[Nr_imagini,linii,coloane,canale]. Deci daca se verifica o singura imagine grayscale, atunci formatul necesar este[1,linii,coloane,1]. Pentru modificarea formei retele se poate folosimatrice = matrice.reshape(Nr_imagini,linii,coloane,canale)